写在前面
Hermes Agent 是 Nous Research 开源的通用 AI Agent。和 Claude Code、Codex 这类主要待在终端里的编程 CLI 不同,它更像一个常驻服务:挂在服务器上,通过飞书、Telegram、企业微信等聊天平台接收消息,按配置调用模型、工具和技能,再把结果送回聊天窗口。
我在一台内网服务器上跑了几个月 Hermes,配置一路改下来,已经从"能用"变成了一套有明确分层的系统。这个系列把它拆开讲清楚,本篇是总览:先建立整体模型,后续每篇再展开一层。
本文基于 Hermes Agent v0.23.0(2026.9.24),使用官方 Docker 镜像部署。涉及账号、渠道 ID、模型网关地址的地方都用占位符替代。
整体模型
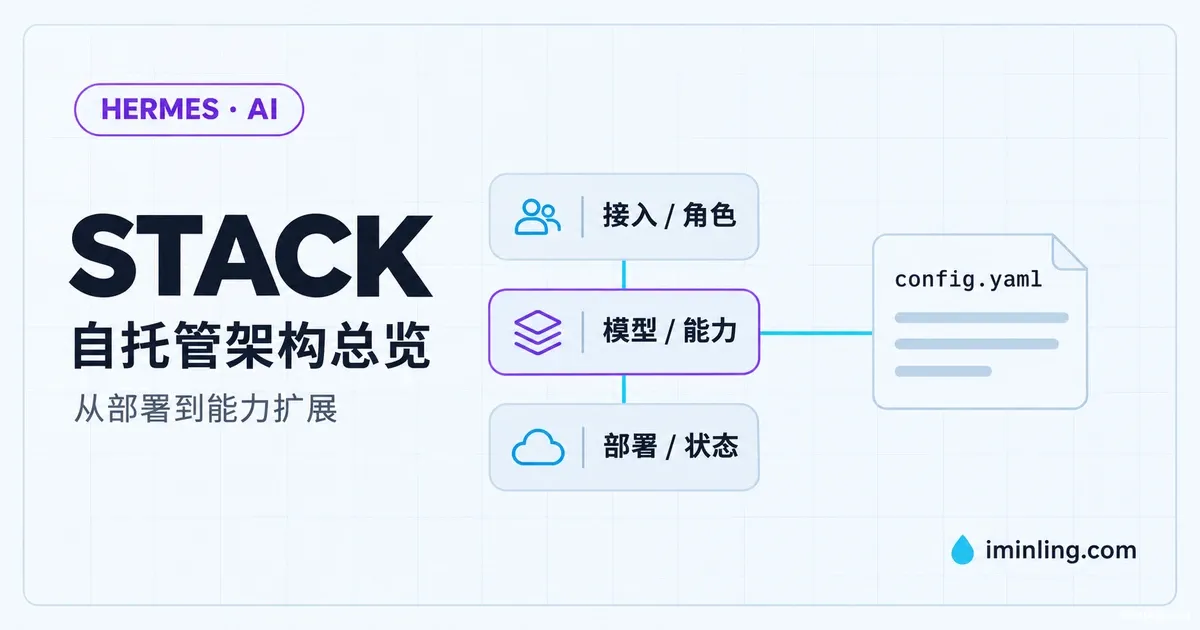
先看全貌。Hermes 在这套部署里可以分成六层:消息从最上面的接入层进来,经过角色层和能力层调用模型,记忆与状态贯穿全程,最底下的部署层承载所有进程和数据。
各层的分工可以用一张表概括:
| 层 | 负责什么 | 主要配置位置 |
|---|---|---|
| 部署层 | 进程守护、数据持久化、Dashboard | docker-compose.yaml、/opt/data |
| 模型层 | 主对话模型、辅助任务模型、多模型协作 | config.yaml 的 model、auxiliary、moa、providers |
| 接入层 | 聊天平台收发、展示策略、会话切换 | config.yaml 的 platforms、display.platforms、.env |
| 角色层 | 按用途隔离模型、技能和记忆 | profiles/<name>/ |
| 能力层 | 技能、插件、定时任务 | skills/、plugins/、cron/、scripts/ |
| 记忆与状态层 | 人设、长期记忆、会话与任务状态 | SOUL.md、memories/、state.db |
关键组件
部署层:一个容器,一个数据目录
整套服务只有一个 hermes 容器,用 Docker Compose 管理:
| |
几个值得注意的点:
- 容器内的
HERMES_HOME是/opt/data。配置、密钥、技能、会话数据库全部落在宿主机的./data里,升级镜像不会丢状态。 command: ["gateway", "run"]让容器以网关模式常驻;容器内部由 s6 负责守护网关进程。- 工作目录
/data/work以只读方式挂载,Agent 能读代码和资料,但不能直接改宿主机文件。 - 服务器只在内网,所以使用
network_mode: host,Dashboard 直接监听9119端口,只配了 Basic Auth。暴露到公网时不应照搬这套配置。
我早期还自己写过一个 Dockerfile,用来在镜像里装 Chromium,后来发现官方镜像已经通过 PLAYWRIGHT_BROWSERS_PATH 自带 Playwright 浏览器,这一步完全多余。部署篇会详细说明数据目录结构和这类踩坑点。
模型层:主模型干活,小模型打杂
模型层最重要的设计是按任务分配模型。
- 主对话使用
grok-4.7,推理强度设为high。 - 上下文压缩、审批判断、标题生成、技能整理(curator)、后台复盘这些辅助任务,统一交给更便宜、更快的
glm-5.3-flash,并关闭推理。
| |
所有模型都通过一个自建的 NewAPI 网关接入,按协议拆成几个 named provider 声明,密钥只通过 key_env 引用环境变量,不写进配置文件。此外还配置了 MoA(Mixture of Agents):用 /moa 标记某一轮时,先让几个不同厂商的模型给出参考意见,再由主模型汇总回答。模型篇会讲清楚这些取舍和成本。
接入层:一个网关,多个聊天平台
Gateway 是 Hermes 和外界的连接点。这套部署启用了:
- 飞书:日常主要入口,也是 home channel
- Telegram:个人移动端入口
- 企业微信、微信:分别给其他 Profile 使用
api_server和webhook:供脚本或其他系统调用
不同平台的展示能力不一样,所以在 display.platforms 中按平台单独调整,例如飞书和 Telegram 关闭中间过程消息,避免刷屏:
| |
角色层:用 Profile 隔离用途
一个 Agent 同时承担开发、产品、测试、知识库问答和家庭事务,技能和记忆很容易互相干扰。Hermes 的 Profile 正好解决这个问题:每个 Profile 有自己的配置、技能集合和记忆。
除了默认的 default,这里按用途又建了五个 Profile:dev、product、tester、kb、home。比如 home 只挂了最基础的技能,kb 只保留知识库问答相关的技能。
配合 gateway.multiplex_profiles: true,同一个网关进程就能同时服务所有 Profile。路由方式很简单:每个 Profile 持有自己的机器人凭证,消息从哪个机器人进来,就交给哪个 Profile 处理。
能力层:Skills、Plugins 和 Cron
能力层是 Hermes 可塑性最强的部分:
- Skills:以
SKILL.md为单位的能力包,按目录分类存放。内置技能很多,我禁用了大部分用不到的,减少提示词占用和误触发。 - Plugins:运行在网关进程里的 Python 扩展。我用了两个插件:一个社区插件在
pre_gateway_dispatch钩子里恢复按时间自动重置会话(上游在v2026.9.11移除了这个能力),另一个是让 Hermes 自己写的本地补丁,让企业微信发送文件失败时回退到主动发送。 - Cron:Hermes 内置的定时任务。除了定时让 Agent 执行提示词,也可以直接运行
scripts/下的脚本,比如每天检查宿主机磁盘占用并告警。
扩展篇会以这两个插件为例,讲 Hermes 插件的两种典型写法。
记忆与状态层:让 Agent 记住自己是谁
SOUL.md:Agent 的人设和说话风格,例如要求回答长度与问题分量匹配、不说客套话。memories/MEMORY.md和memories/USER.md:长期记忆和用户画像,分别有2200和1375字符上限,逼着记忆保持精炼。state.db:会话、消息、全文检索等运行状态,启用了 WAL 模式。跑了几个月后已经涨到两百多 MB,需要关注清理和备份。session_reset:每天凌晨 4 点切换新会话,避免上下文无限增长(新版本需要插件配合才生效)。
一条消息的完整路径
把各层串起来,一条飞书消息大致经过这些步骤:
这套架构的边界
- 前提是内网:Dashboard 只有 Basic Auth,审批模式也是关闭的(
approvals.mode: 'off')。这套配置建立在服务器不对外暴露、使用者都可信的前提下。 - 单容器单点:所有能力都在一个容器里,容器出问题,所有渠道一起失效。对个人和小团队够用,但要接受这个单点。
- 跟随
latest镜像:升级方便,但上游行为变化会直接影响现有配置。会话重置能力被移除,就是一个真实例子。
系列规划
后续文章按层展开:
- 部署篇:Docker Compose、s6 启动链、数据目录结构、Dashboard、升级与备份
- 模型篇:自定义 provider、主辅模型分工、上下文压缩与缓存、MoA
- 接入与 Profile 篇:多平台 Gateway、Profile 多路复用、会话划分与重置
- 扩展篇:Skills 管理、插件开发、Cron 脚本任务
- 番外:提示词缓存排查:接入 New API 时 GPT、Grok、GLM、Claude 的缓存协议与逐层取证
总结
Hermes 的配置项很多,按层来看就清晰了:部署层保证常驻和数据持久,模型层决定成本和能力,接入层和角色层决定谁在什么场景下用它,能力层和记忆层决定它能做什么、记得什么。改一个配置之前先想清楚它属于哪一层,就不容易越改越乱。